

2026 Q2-Q3 找 remote SDE 经历 - System Design - 3 跳槽
robin888
上一篇讲 Coding,
https://www.1point3acres.com/bbs/thread-1188516-1-1.html
这篇讲System Design, 前半部分是题型和必备概念的总结,后半部分是我实际遇到的 10 道真题拆解(题目 + 架构 + 关键点)。
在被多个行业, 多家公司拷打之后,我把几乎所有问到和涉及的 topic 都整理进了一份 Knowledge Base,可以直接 import 给你的 AI 让它 go over 一遍(内容很多,足够出书…):
https://www.1point3acres.com/bbs/thread-1188552-1-1.html
(Disclaimer: 已经用AI润色过,推荐在电脑上看,大家批判着看。如果要转载请注明出处)
Part 1 · 题型与必备概念
1. 经典题还是要复习
老题不难, 但真遇到的时候想不起关键算法会尴尬, 至少过一遍:
2. AI Agent 设计题(新流行)
Chatbot 型
3. 高频:Payment Async Event(至少 5 家公司问过)
这一类强烈建议一定好好准备,分两个小类:
1. Payment Async Event — Single Process
处理单个 3rd party API 或 Webhook 发来的 event。
核心概念:event status control、idempotent key、lock(pessimistic vs optimistic)。
2. Payment Async Event — Fan-out
例:Design a Pub/Sub system from a payment service
支付系统里一笔支付会产生很多事件,多个下游服务要消费这些事件。这里的重点是:event 已经在 DB 里了,怎么可靠地 fan out 到多个下游。
核心概念:Kafka、partition、consumer group、outbox、inbox、relay。
大致题目可以看Part 2 真题拆解
3. Lock / Concurrency 四种机制
4. AI Agent 专属 concept
这几个问题几乎每场 AI 系统设计都会被追问,最好准备成能脱口而出的答案:
Part 2 · 10 道真题拆解
下面是一些我这轮实际遇到的比较有代表性的题。每题只保留三样东西:题目在问什么、架构流程图、真正的考点——那些通用的 add-on(加缓存、加监控之类)就不重复了。
1. Sensor Data(IoT store-and-forward)
IoT Sensor(本地持久队列: SQLite / 环形缓冲)
→ HTTPS + mTLS + 签名 + nonce
→ LB → Ingress(验签 / 验证书 / 拒重放)
→ Kafka(partition by sensor_id, 削峰)
→ Consumer(幂等去重 + 乱序判定)→ Analysis API (gRPC)
→ Postgres(append-only, pg_partman 按 date 分区)→ CDC → ClickHouse
核心设计(store-and-forward)
2. 防止 Nightly Sync Cron Job 覆盖人工修改
核心方案:条件 UPDATE(不是显式行锁)
3. Chat Room(聊天室实时化改造)
实时化:双路径分离
4. Facebook Feed
Fan-out 策略(核心)
5. 商家Repricing
三个保证(核心)
6. Ad Event Ingest and fanout
哪层要 SKIP LOCKED(核心追问)
7. Mongo → Postgres 迁移
先跑 Schema Profiler(灵魂)
8. Monthly Billing Workflow
别硬套双路径(核心)
9. Voice AI(外呼语音 AI 编排平台)
控制面:编排、限流、隔离
10. Prompt 生成视频(Agentic + RAG)
Workflow① Offline (视频库构建):
web crawler → 视频 → S3 → CLIP(Modal) → video embedding → pgvector
用LLM吗?
→ CLIP: 专门的embedding模型(不是生成LLM)
→ crawler/S3: 工程/存储
② Realtime:
a. Prompt Convert(LLM理解 + query embedding):
→ LLM理解/改写: 用LLM (理解意图, 可选/便宜模型)
→ query embedding(CLIP): 专门embedding模型
b. ReAct循环:
→ 召回(ANN 100k→100): 算法(向量检索)
→ rerank(→top10): cross-encoder模型(不是LLM)
→ LLM推理: 用LLM (决策: 够好吗/重试/选哪个)
→ verifier判断: 用LLM (独立验证视频符合prompt)
c. Video Response Service:
→ 合成视频(FFmpeg): 工具(视频处理)
→ S3/CDN: 存储/分发
→ SSE/webhook通知: 工程
③ 视频交付:
→ SSE/CDN
Agent 编排(核心)
小结
感谢你看到这里!我感觉这一章的内容之多, 可以出本小册子了。。。总结一下,
传统的系统设计没什么变化,还是老一套。
这次明显感觉到:async event 的幂等处理、lock / distributed lock、以及 fan-out 被多家公司考到——有的放在 PR debug 里考,有的放在 system design 里考,请多多复习。
AI 的系统设计现在群魔乱舞,面什么的都有。建议还是从最基础的几种准备起:RAG、AI agent (ReAct)、多模态 (chatbot 文本 / 视频、语音客服)
总体来说在AI时代,System Design 的权重似乎加重了,因为有公司连出 3 轮 SD, 完全没coding。
最后一句心得:AI Agent Engineer 首先需要掌握传统的系统设计,这是地基。
下一章讲 Hiring Manager round 和其他体会。
https://www.1point3acres.com/bbs/thread-1188516-1-1.html
这篇讲System Design, 前半部分是题型和必备概念的总结,后半部分是我实际遇到的 10 道真题拆解(题目 + 架构 + 关键点)。
在被多个行业, 多家公司拷打之后,我把几乎所有问到和涉及的 topic 都整理进了一份 Knowledge Base,可以直接 import 给你的 AI 让它 go over 一遍(内容很多,足够出书…):
https://www.1point3acres.com/bbs/thread-1188552-1-1.html
(Disclaimer: 已经用AI润色过,推荐在电脑上看,大家批判着看。如果要转载请注明出处)
Part 1 · 题型与必备概念
1. 经典题还是要复习
老题不难, 但真遇到的时候想不起关键算法会尴尬, 至少过一遍:
- URL Shortener
- Rate Limiter
- Typeahead
2. AI Agent 设计题(新流行)
Chatbot 型
- Text chatbot
- Voice customer support(Temporal + LLM + Voice-to-Text)
- Video chatbot(RAG + CLAP 类多模态)
- Doc read + rule-based system(two-pipeline 架构)
- 做物流、采购的,分析 provider 的文件;
- 做报税的,分析 CPA 的税表;
- 做 Healthcare 的,分析各种医疗文件。
3. 高频:Payment Async Event(至少 5 家公司问过)
这一类强烈建议一定好好准备,分两个小类:
1. Payment Async Event — Single Process
处理单个 3rd party API 或 Webhook 发来的 event。
核心概念:event status control、idempotent key、lock(pessimistic vs optimistic)。
2. Payment Async Event — Fan-out
例:Design a Pub/Sub system from a payment service
支付系统里一笔支付会产生很多事件,多个下游服务要消费这些事件。这里的重点是:event 已经在 DB 里了,怎么可靠地 fan out 到多个下游。
核心概念:Kafka、partition、consumer group、outbox、inbox、relay。
大致题目可以看Part 2 真题拆解
3. Lock / Concurrency 四种机制
| 机制 | 写法 | 用在哪 |
| Distributed Redis lock | SET key val NX EX | |
| Lua 校验 owner 释放 | 跨系统/跨服务的抽象资源 | |
| Pessimistic lock | SELECT ... FOR UPDATE SKIP LOCKED | 多 worker 抢同一张表的行 |
| 何时用skip locked, 何时不用 | ||
| Optimistic lock | UPDATE ... WHERE version = ? | 读-改-写、防旧覆盖新 |
| 唯一约束去重 | INSERT ...(unique constraint) | 幂等 |
4. AI Agent 专属 concept
这几个问题几乎每场 AI 系统设计都会被追问,最好准备成能脱口而出的答案:
- 怎么 prevent hallucination(grounding / verifier / structured output)
- 怎么 reduce token usage(context compression / prompt caching / structured state)
- 怎么 improve quality(user feedback / offline eval + CI / realtime verifier)
- 怎么加 input / output guardrail
- Average ReAct loop 数 + Average token cost——要有实数感 (e.g 2 rounds, $0.08 total),别只会说"取决于场景"
Part 2 · 10 道真题拆解
下面是一些我这轮实际遇到的比较有代表性的题。每题只保留三样东西:题目在问什么、架构流程图、真正的考点——那些通用的 add-on(加缓存、加监控之类)就不重复了。
1. Sensor Data(IoT store-and-forward)
题目:传感器数据采集。设备会长时间断网,要求断网期间数据不丢、恢复后可靠补发,同时设备身份可信、数据可审计分析。核心矛盾:断网期间不丢 + 恢复后可靠补发(且补发会带来重复和乱序)
IoT Sensor(本地持久队列: SQLite / 环形缓冲)
→ HTTPS + mTLS + 签名 + nonce
→ LB → Ingress(验签 / 验证书 / 拒重放)
→ Kafka(partition by sensor_id, 削峰)
→ Consumer(幂等去重 + 乱序判定)→ Analysis API (gRPC)
→ Postgres(append-only, pg_partman 按 date 分区)→ CDC → ClickHouse
核心设计(store-and-forward)
- 读数先写本地持久队列,每条带 event_time + 单调递增 seq。
- ACK 握手:发 batch → 服务器处理 → 返回已确认的 event_id 列表 → 设备才擦除本地;没收到 ACK 就保留重发。
- 队列满了要有策略:环形覆盖最老(保新)或降采样, 存储有限必须考虑。
- 重发必然产生重复 → 服务端幂等:UNIQUE(sensor_id, event_id)。
- 乱序是隐藏坑:10:35 补发 10:00 的数据,同时 10:36 的实时数据也在发,服务器可能先收到新的 → DB 写入/状态更新必须按 event_time 判定,老数据不覆盖新状态(终态不回退)。
- 批量补发冲击服务器:设备端限速补发 + Kafka 削峰 + 标记"补发 vs 实时",实时优先。
- HTTPS 已提供传输加密(保密性);要额外做的是证明身份(真实性 + 完整性)——这是签名,不是加密。
- 标准做法:出厂烧录唯一身份 + device certificate + mTLS 双向验证(私钥存 HSM 永不离开设备),证书可吊销。
- 防重放:加 nonce 或时间戳 + 序号,拒绝太老/重复的;event_id 的幂等去重顺便也防了重放。
- 认证只防"冒充",防不了设备被撬开改数据 → 加异常检测(如温度突然 1000 度)标记可疑读数。
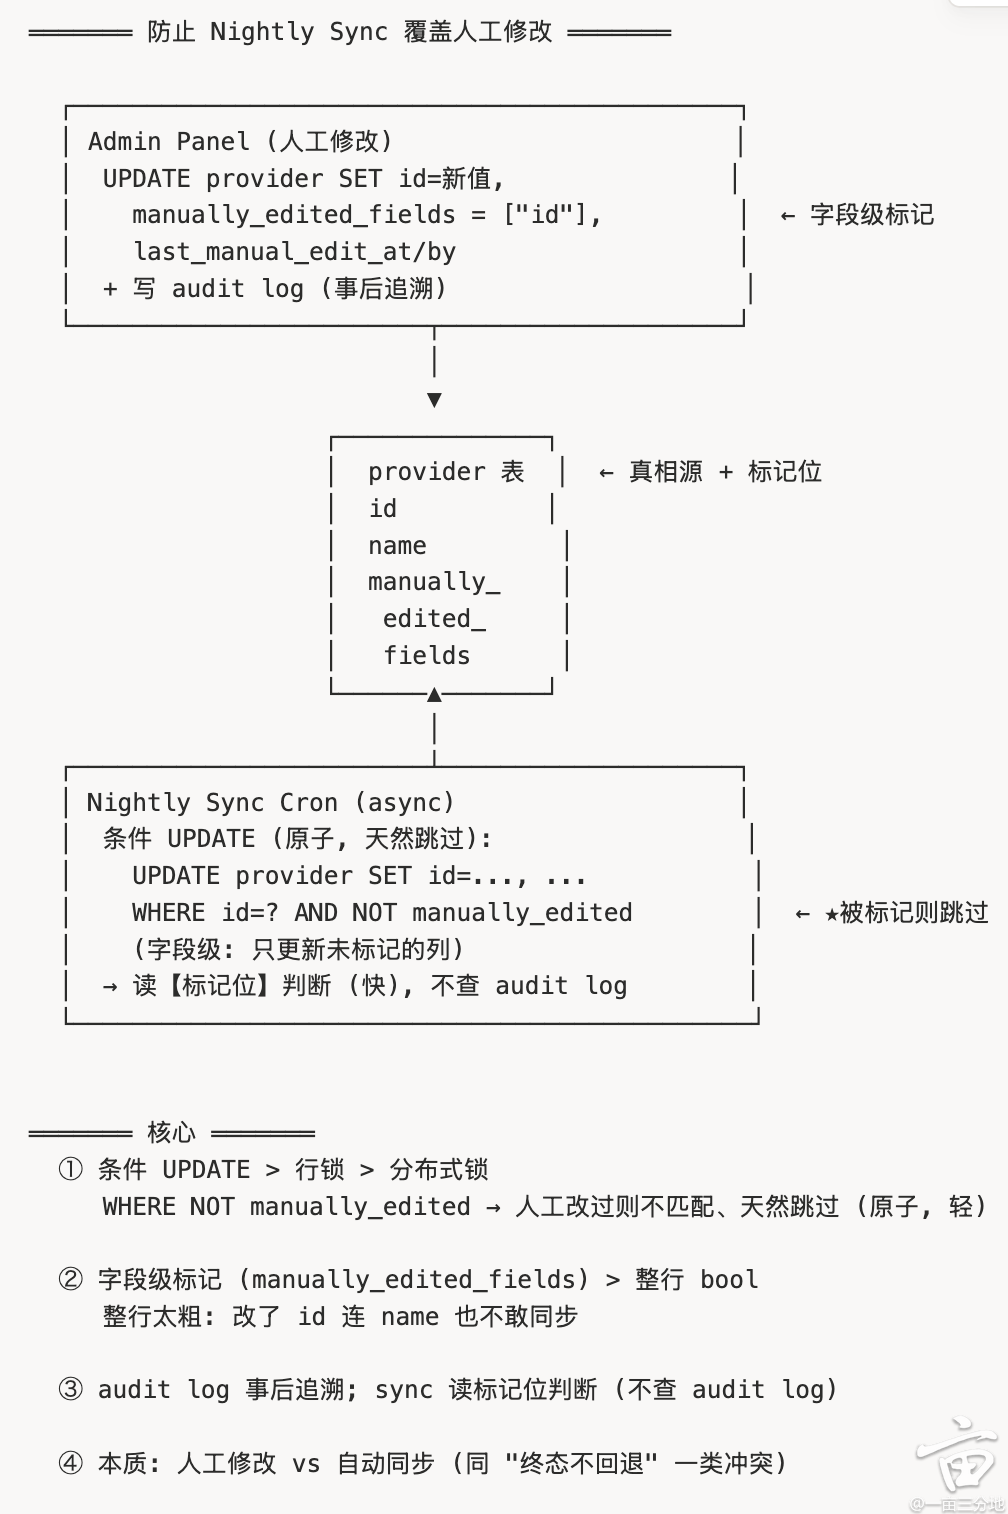
2. 防止 Nightly Sync Cron Job 覆盖人工修改
题目:内部 admin panel 允许管理员更新 provider 的 数据,比如ID,如何防止每晚的 sync cron job 同步把人工改过的值覆盖掉?核心矛盾:人工修改 vs 自动同步的优先级冲突(本质和"终态不回退""外部同步 vs 本地修改"同类)。解法:给人工改过的字段打标记,sync 用条件 UPDATE 天然跳过被标记的——比显式行锁更轻。
核心方案:条件 UPDATE(不是显式行锁)
- Race condition:sync 读到"没人工改"正准备写,同时 admin 改了并打标记 → sync 把 admin 的修改覆盖掉。
- 首选条件 UPDATE:UPDATE provider SET ... WHERE id=? AND NOT manually_edited——被人工改过则 WHERE 不匹配、天然跳过,原子、比 SELECT FOR UPDATE 更轻。
- 这是那条通用优先级的实例:条件 UPDATE > 行锁 > 分布式锁。
- SELECT FOR UPDATE 也可行(行锁让另一方等),但只在逻辑复杂时才需要。
- Schema 加:manually_edited_fields(如 ["id"])+ last_manual_edit_at
- last_manual_edit_by。
- 整行 bool 粒度太粗:改了id就连 name 也不敢同步了 → 字段级只保护改过的那几列,其他列照常同步。
- audit log 只用于事后追溯(谁改的、什么时候)。
- sync 的判断读 provider 表上的标记位(快),不去查 audit log(JOIN 大表慢)。
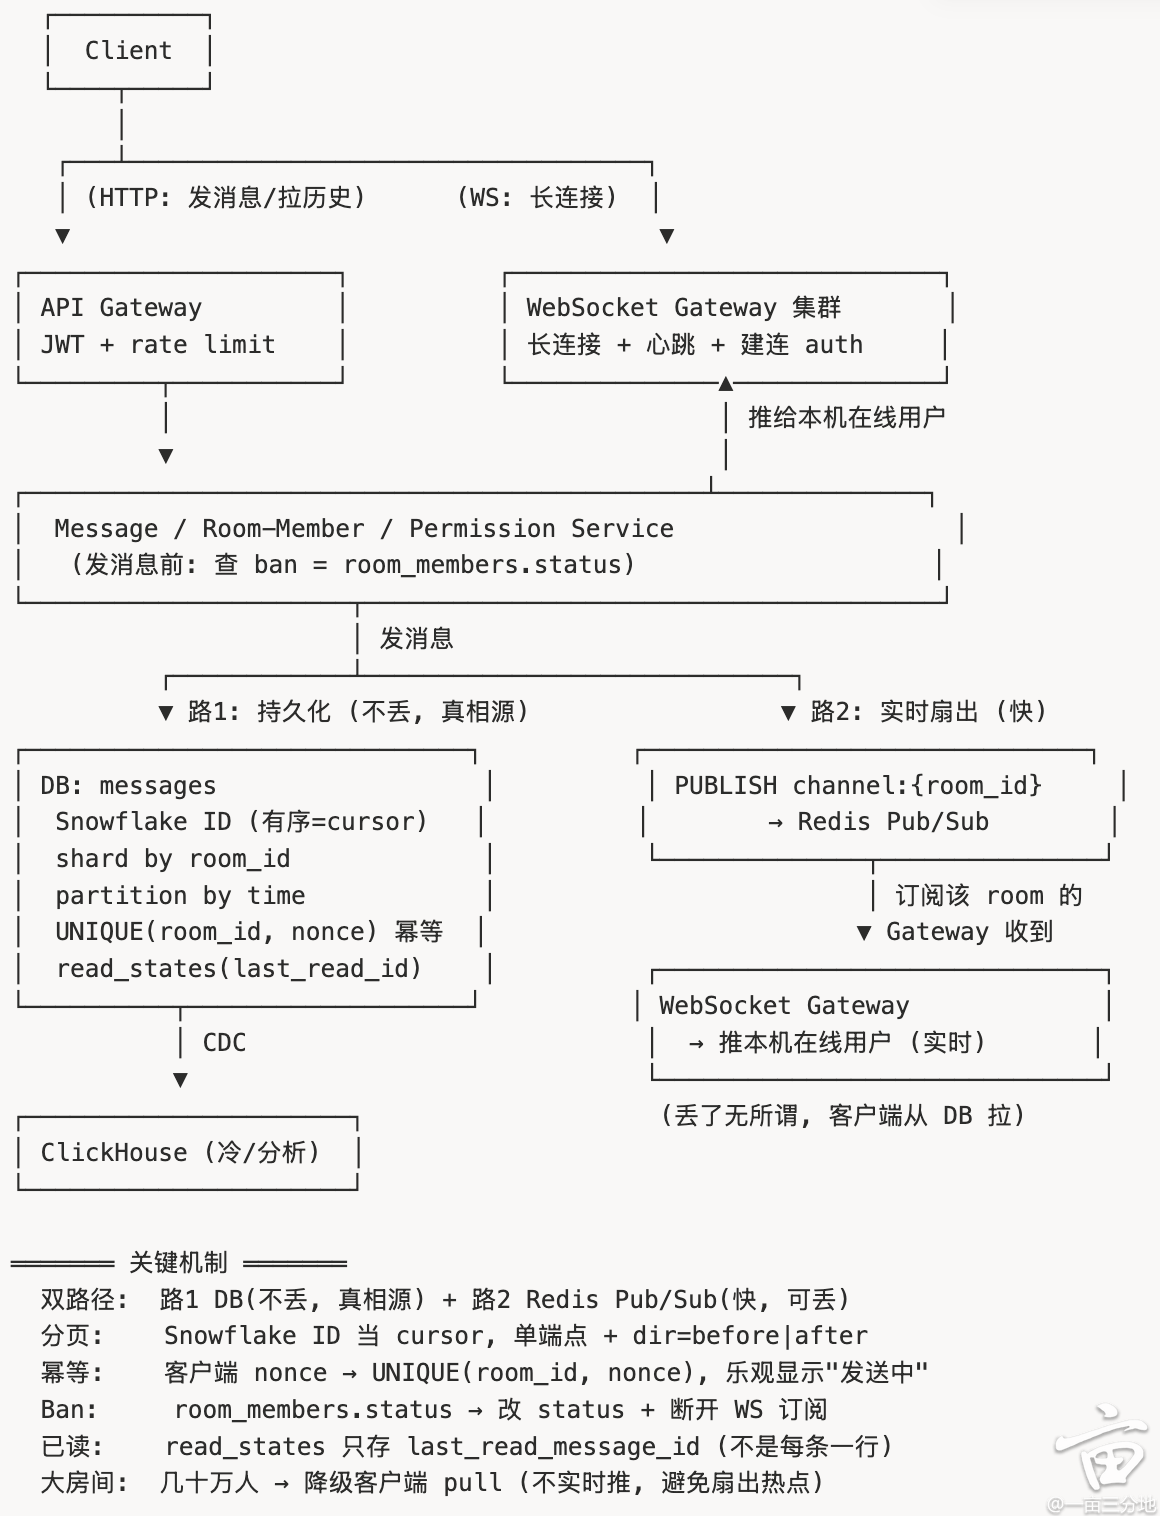
3. Chat Room(聊天室实时化改造)
题目:现有方案是每 10 秒轮询(浪费、延迟高、QPS 随用户数爆炸),要求改造成实时推送,并设计消息分页、幂等发送、权限/ban 与已读message。核心矛盾:轮询 → 实时推送(WebSocket);同时持久化路(不丢) 与 实时扇出路(快) 分离——两条路各司其职。
实时化:双路径分离
- 两条路径:持久化路走 DB(不丢,真相源),实时扇出路走Redis Pub/Sub(快,丢了无所谓——客户端会从 DB 拉)。
- 大房间扇出会热点:几十万人的房间降级为客户端 pull、不实时推(避免一条消息扇出几十万次)。
- WebSocket Gateway 集群:长连接 + 心跳 + 建连时 auth。
- Snowflake ID(timestamp + machine_id + serial)天然有序,直接当 cursor:WHERE snowflake_id < last_cursor ORDER BY snowflake_id DESC LIMIT 50。
- 分页单端点 + dir 参数(?cursor=X&limit=50&dir=before|after),不拆 next/prev 两个端点;响应回 next_cursor / prev_cursor。
- 幂等发送:客户端带 nonce(网络重试不重复发),DB UNIQUE(room_id, nonce);发送方乐观显示"发送中",服务器确认后标记已发。
- Ban:发消息前查权限,ban 的真相在 room_members.status;ban 时改 status 并断开 WS 订阅。
- 已读不能每条一行:read_states(user_id, room_id, last_read_message_id) 只存"读哪"。
- 资源标识进 path,过滤/分页进 query:GET /rooms/{room_id}/messages而不是 GET /messages?room_id=X。
- 密码 bcrypt 加盐(不只是 hash);JWT 带 TTL + refresh token;WebSocket 建连也要 auth。
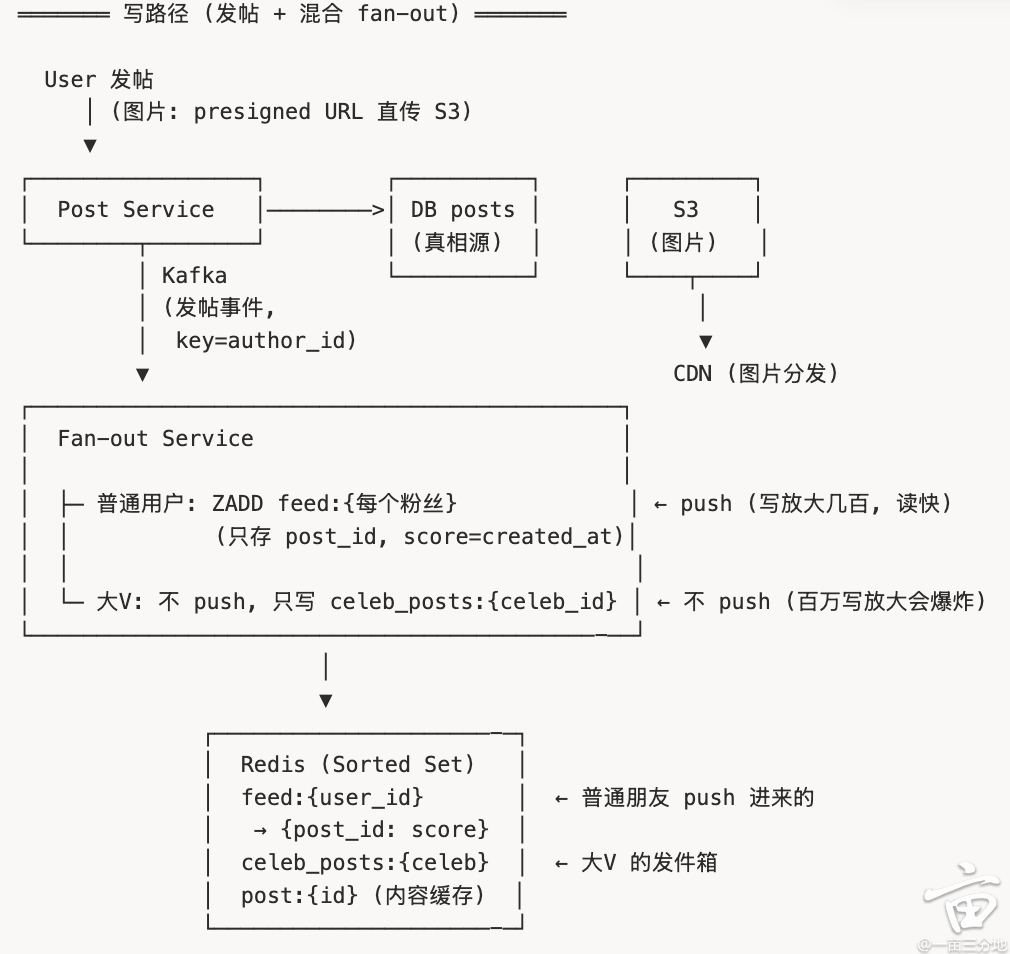
4. Facebook Feed
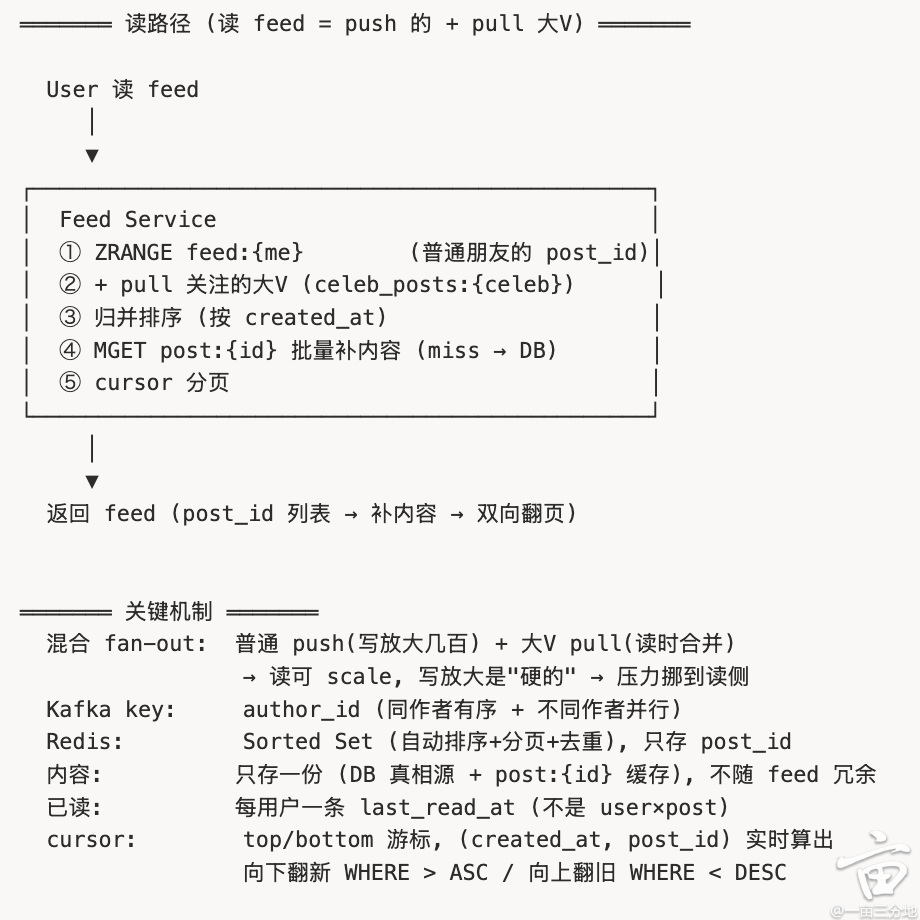
题目:设计社交网络的 feed(发帖、图片、好友关系、feed 读取)。核心考点是 fan-out 策略、大 V 热点、已读追踪与双向 cursor 分页。很传统的经典题。核心矛盾:混合 fan-out——普通用户 push(写时预生成 feed,读极快),大 V 不 push(百万写放大会爆炸),粉丝读时 pull 合并。一句话理由:读可以 scale(缓存/副本/CDN),写放大是"硬的",次数躲不掉——把压力从写侧挪到读侧。
Fan-out 策略(核心)
- 混合 fan-out 是标准答案:普通用户 push(写放大只有几百,读极快);大 V 不 push(百万写放大会爆炸),只写自己的发件箱,粉丝读时 pull 合并。
- Kafka partition key = author_id:同作者事件有序 + 不同作者并行。
- 澄清两种 "push":发帖时 fan-out on write(大 V 会爆炸)vs 给活跃,用户预先算好 feed(那是 pull 结果被预计算,属读侧优化,不涉及写放大)。
- 用 Sorted Set 而非 list:feed:{user_id} → {post_id: score= created_at},自动排序 + 分页 + 去重,cursor 分页用 ZRANGE。
- 只 push post_id,不 push 内容:读时两步——Redis 拿 id 列表(快)
- 批量补内容(MGET post:{id},miss 回 DB)。内容只存一份(DB 真相源), 不随 feed 冗余。
- 不能每个 user × post 一条(量级爆炸):改为每用户一条 last_read_at,判定 post.created_at <= last_read_at 即已读。
- 客户端维护 top/bottom 两个游标:向下翻新 WHERE > next_cursor ASC,向上翻旧 WHERE < prev_cursor DESC;cursor 由本页首尾的 (created_at, post_id) 实时算出(复合游标防同一时间多条)。跟上一题类似。
- 排序先做 created_at 倒序时间线,主动补一句可扩展到 ranking(互动预测 ML 排序)。
5. 商家Repricing
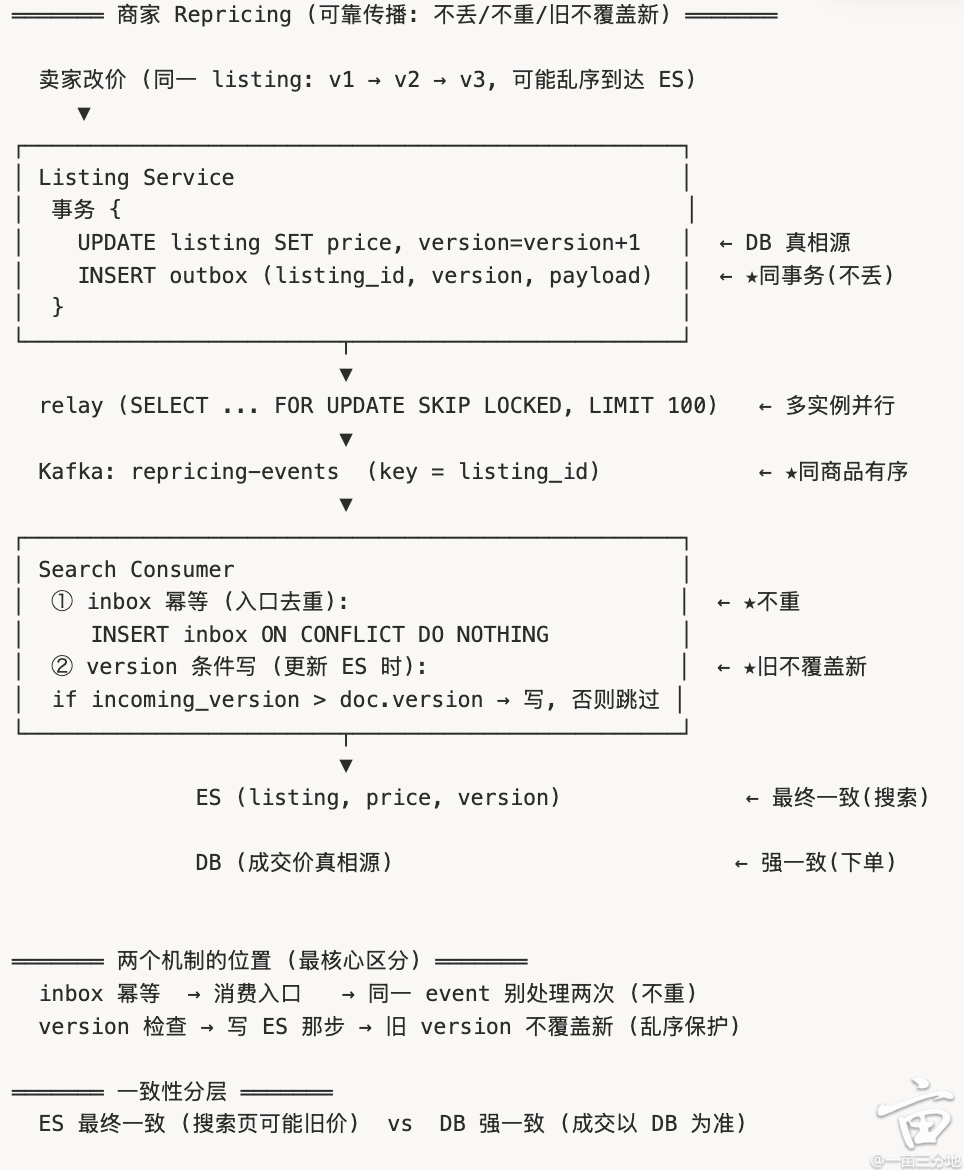
题目:电商卖家改价(同一 listing 连续 v1 → v2 → v3)如何可靠地传播到搜索索引 ES,保证不丢事件、不重复处理、旧价不覆盖新价。核心矛盾:三个保证——不丢(Outbox 与业务同事务)、不重(inbox 幂等)、旧价不覆盖新价(version 条件写)。最核心的区分:inbox 和 version 是两个不同机制、位置不同。
三个保证(核心)
- 不丢:UPDATE listing + INSERT outbox 在同一事务(业务改了事件一定发);relay 用 FOR UPDATE SKIP LOCKED 多实例并行发 Kafka。
- 不重(inbox 幂等):INSERT INTO inbox(event_id) ON CONFLICT DO NOTHING RETURNING event_id,没插入就直接 return。位置在消费入口(同一 event 别处理两次)。
- 旧价不覆盖新价(version):ES 文档存 version,更新时if incoming_version > doc.version 才写,否则跳过。位置在更新 ES那一步。
- inbox vs version 是两个不同机制、位置不同——inbox 在入口去重,version 在写 ES 时防旧覆盖新。这是这道题最核心的区分。
- repricing 是 listing 粒度的变更;按 user_id 分区会让同卖家的不同商品串行,语义也不对。
- 幂等键 listing_id + version 要和 partition key 对齐同一实体。
- ES 最终一致:搜索页可能看到旧价。
- 成交价以 DB 为准:点进详情 / 下单走 DB。
- 要主动讲这个分层,否则会被追问"用户看到的价格和实际不一样怎么办"。
- 同款同 size 多卖家挂不同价,买家看最低价 → 改价后要更新该 SKU 的最低价聚合(Redis sorted set,最低价 = 第一个)。
- 常见的自动 repricing(比最低价低 $1)会造成高并发改同一 SKU →需要并发控制。
- 改价生效后经 CDC → SSE 通知卖家"你现在是最低价 / 已被超越"。
6. Ad Event Ingest and fanout
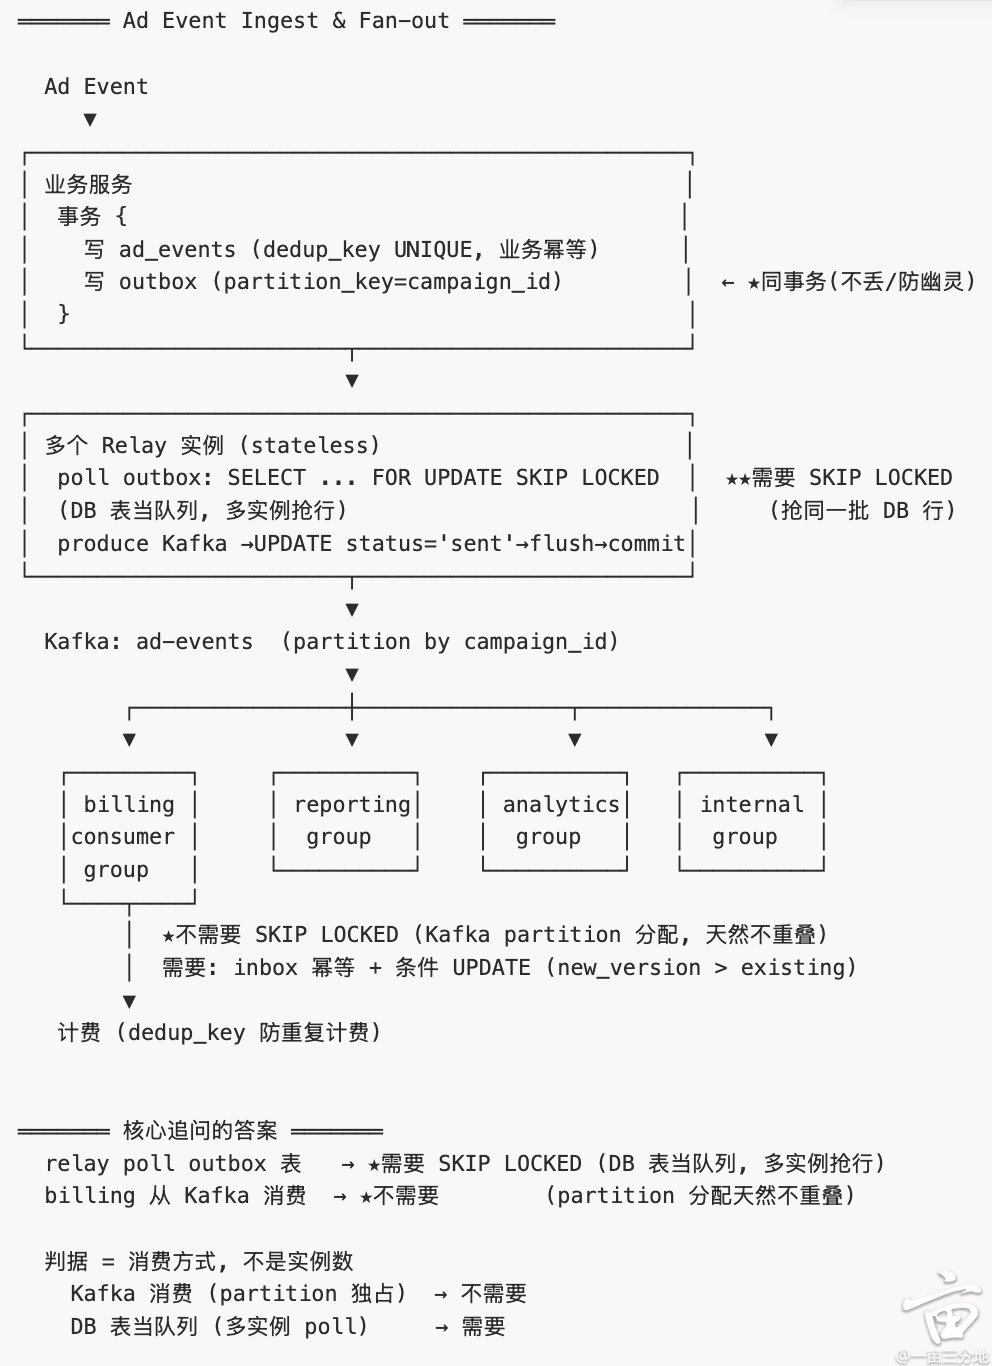
题目:多个 stateless relay 处理 ingress 的 ad event,fan out 到 downstream services, e.g billing / reporting / analytics 。核心追问:哪一层需要 SELECT FOR UPDATE SKIP LOCKED,哪一层不需要?核心结论:SKIP LOCKED 解决的是"多 worker 抢同一批 DB 行"——所以只用在 relay poll outbox 表那一层;billing 从 Kafka 消费靠partition 分配天然不重叠,不需要 SKIP LOCKED。判据是消费方式,不是实例数。
哪层要 SKIP LOCKED(核心追问)
- relay poll outbox 那层需要:把 DB 表当队列、多实例 poll →要 SKIP LOCKED 防抢同一行。
- billing 从 Kafka 消费不需要:Kafka 一个 partition 只给 group 内一个 consumer → 天然不重叠。
- 判据是消费方式,不是实例数:Kafka 消费 → 不需要;DB 表当队列多实例poll → 需要。
- billing 那层需要的是事务 + 条件 UPDATE:new_version > existing_version 才计费并更新inbox。inbox 是"记录处理到哪个version"的版本记录,不是抢任务的队列。
- 写库成功但发 Kafka 失败 → 丢事件;发成功但业务库回滚 → 幽灵事件 ——两个系统无法原子。所以业务写 outbox(与业务数据同事务),relay再消费 outbox 发 Kafka。
- 角色分清:业务服务负责写 outbox,relay 只消费 outbox 发 Kafka,不 create outbox。
- relay 是 at-least-once:发 Kafka 成功但标记前崩溃 → 事务回滚 →下次重发 → 下游必须靠 dedup_key 幂等防重复计费。
- 业务表幂等:dedup_key = user_id:campaign_id:ad_break_id:type
- UNIQUE 约束,捕获 UniqueViolation 即视为重复直接返回。
- 循环内 produce(key=partition_key)+ UPDATE outbox SET status='sent', 最后 kafka.flush() 再提交事务——保证发出去了才标记。
7. Mongo → Postgres 迁移
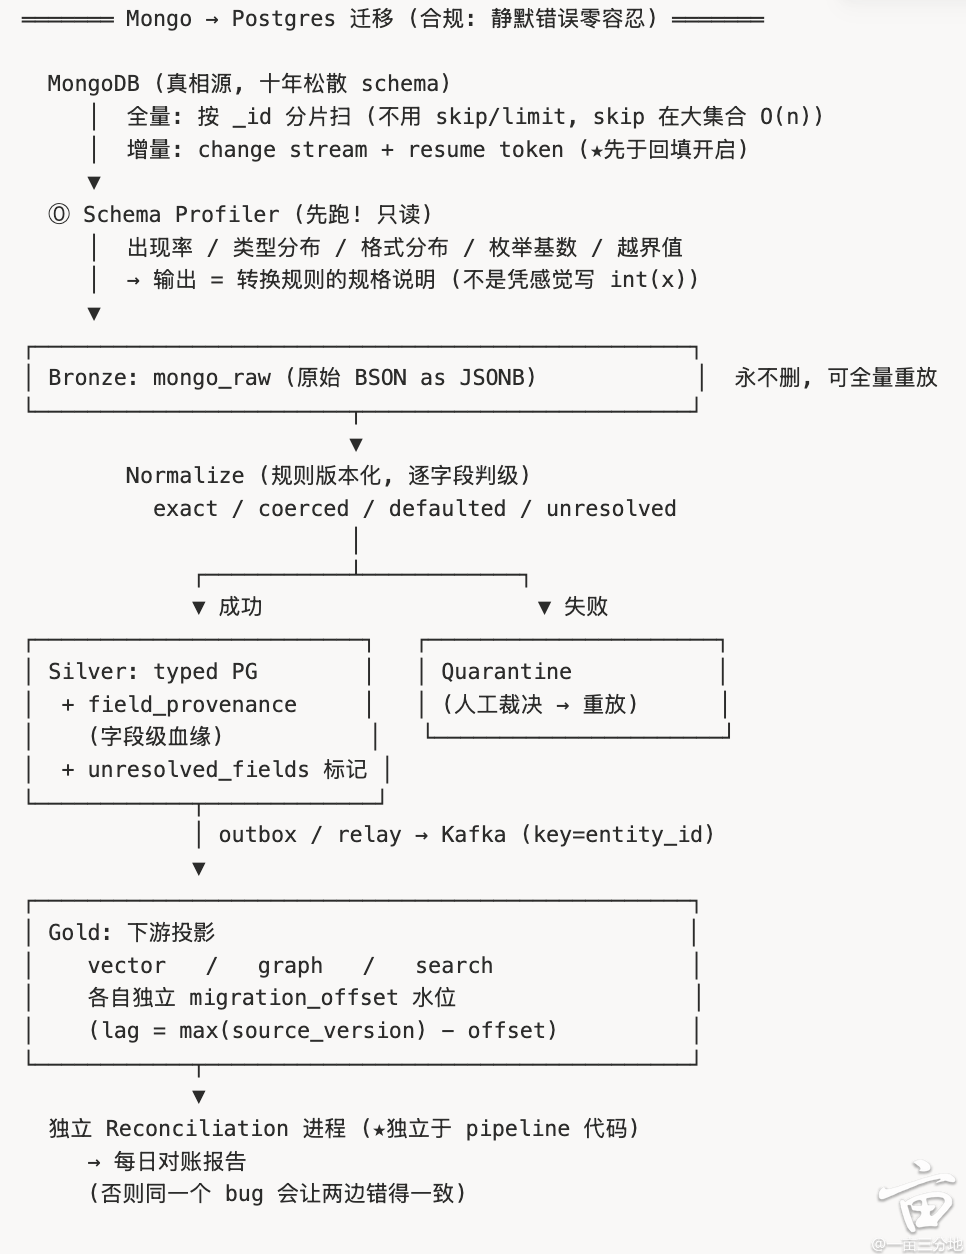
题目:把一个十年历史、schema 纪律松散的 MongoDB 真相源迁移到干净的强类型 Postgres,静默错误会构成 compliance 问题;迁移后还要持续与 Mongo 保持同步,并把归一化数据分发到 vector / graph / search 等下游库,要求字段级不丢信息、不产生重复记录。核心矛盾:静默错误 = 合规问题 → 三条铁律:先摸清再转换(Schema Profiler)、字段级可追溯(血缘 + 四级转换)、转不动的不丢也不硬塞(quarantine)
先跑 Schema Profiler(灵魂)
- 写 pipeline 前先跑只读 Profiler,统计每个字段路径的:出现率(employee_id 出现在 98.7% 文档)、类型分布(string 71% / int 28%/ null 0.9%)、格式分布(ISO8601 62% / MM-DD-YYYY 31% / epoch 7%)、枚举基数、越界值。
- Profiler 的输出就是转换规则的规格说明——而不是工程师凭感觉写int(x)。
- 三层:Bronze(原样存 JSONB,可重放)/ Silver(typed + 血缘 + 隔离区)/ Gold(下游投影)。
- 字段级血缘 field_provenance:主键 (entity_type, entity_id, field_path),存 source_value / target_value / rule_version / confidence / source_offset——每个字段怎么来的可追溯。
- 转换分四级并记录级别:exact("123"→123)/ coerced(多种日期→date,记哪条规则)/ defaulted(缺失 country→'US',必须业务签字)/ unresolved("N/A"、"see notes" → 进 quarantine)
- 20 字段 18 成功 2 失败 → 不整条丢也不硬塞:失败字段进 quarantine,typed 表标 unresolved_fields
- 关键区分:「Mongo 本来没这字段(NULL)」必须区别于「有值但转不动(unresolved)」——两者在 PG 里都是 NULL,但合规意义天差地别
- 顺序:先记 T0 resume token 并开启 change stream(只写 buffer 不消费) → 按 _id 范围分片扫(不能用 skip/limit,skip 在大集合是 O(n))→ 回填完从 T0 重放 → 全部 upsert + version 条件写自动去重。
- change stream 必须先于回填开启,否则回填期间的变更会丢。
- oplog 是有限环形缓冲:消费者挂太久 → ChangeStreamHistoryLost必须全量重扫(要监控剩余窗口)
- update 默认只给 delta:要设 fullDocument: 'updateLookup',但那是事后查询拿到查询时刻的文档 → 必须按 clusterTime 比版本。
- invalidate(drop/rename)会终止 stream:需告警。
- 每个下游独立 migration_offset 水位(优于 Kafka consumer group offset):可精确重放而不动 consumer group,max(source_version) - offset 直接就是 lag。offset 必须与写入同务;不支持事务的 vector 库则先写下游后记 offset——宁可重复(幂等挡)不可丢失。
- 对账进程必须独立于 pipeline 代码,否则同一个 bug 会让两边错得一致。
8. Monthly Billing Workflow
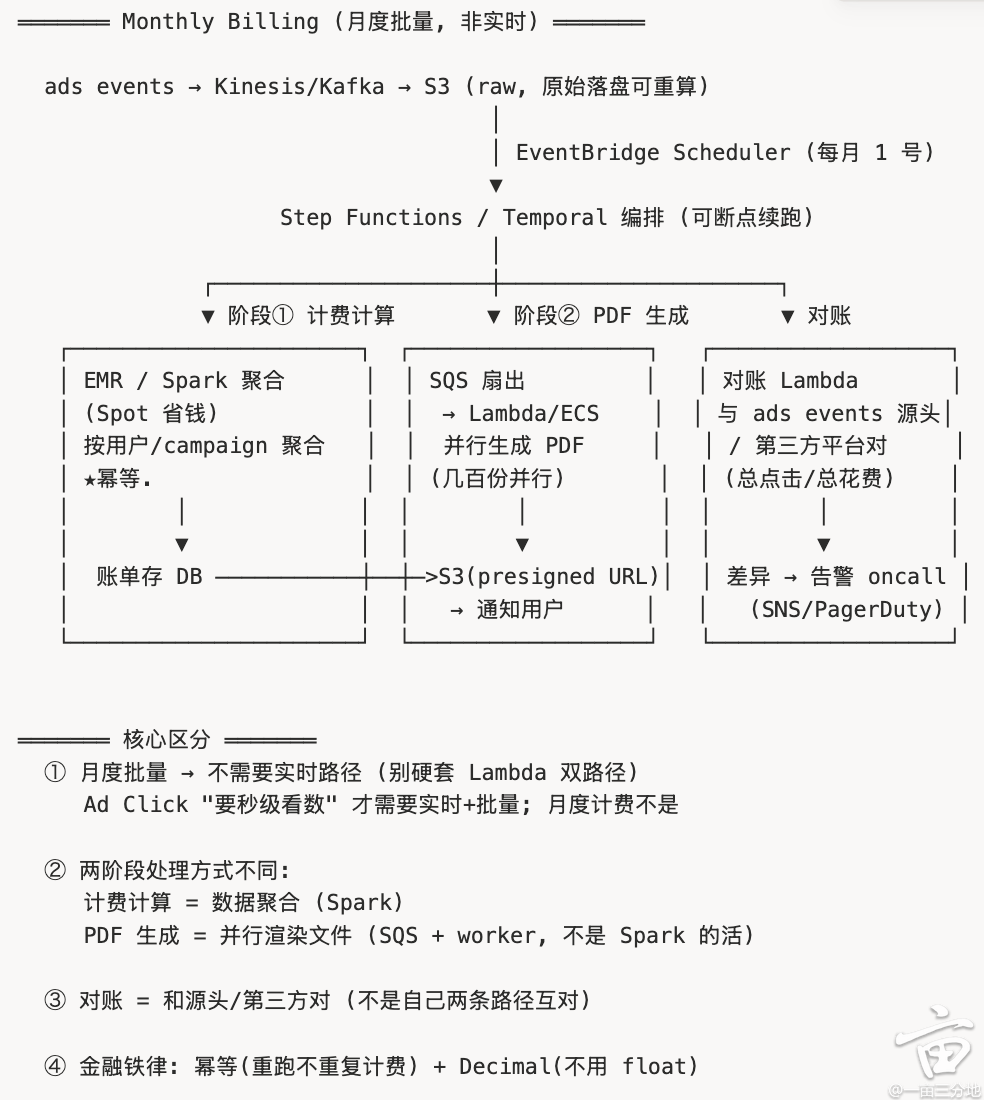
题目:ads event 月度账单(计算 + PDF 生成 + 对账)如何编排?核心矛盾:计费是月度批量,不需要实时路径——一条准确的批处理就够,别为套用架构而双路径(Ad Click 那种"要秒级看数"才需要实时+批量)。且对账要和源头对,不是自己两条路径互对。
别硬套双路径(核心)
- 计费是月度批量,不需要实时路径,一条准确的批处理就够。
- 别为了套架构而双路径——Ad Click 那种"要秒级看数"的场景才需要实时+批量;月度计费不是。
- 计费计算(数据聚合):EMR/Spark 从 S3 读这个月 events → 按用户/campaign 聚合 → 账单存 DB。必须幂等(重跑不重复计费)
- PDF 生成(渲染,天然扇出并行):每个用户每份账单一个任务,SQS分发给 Lambda/ECS worker,几百份并行生成。
- 两阶段处理方式不同:计算是数据聚合(Spark),PDF 是并行渲染文件(不是 Spark 的活)。
- 和 ads events 源头 / 第三方广告平台对账(总点击数、总花费),而不是"自己的两条路径互相对"。
- 差异告警走 SNS / PagerDuty → oncall。
- 交付用 S3 + presigned URL 或邮件通知,别让后端扛下载流量。
- Spark 用 Spot 实例(可中断的批处理,省 70–90%)。
- 编排用 Step Functions / Temporal(多步 + 崩溃可断点续跑);EventBridge Scheduler 每月 1 号触发。
9. Voice AI(外呼语音 AI 编排平台)
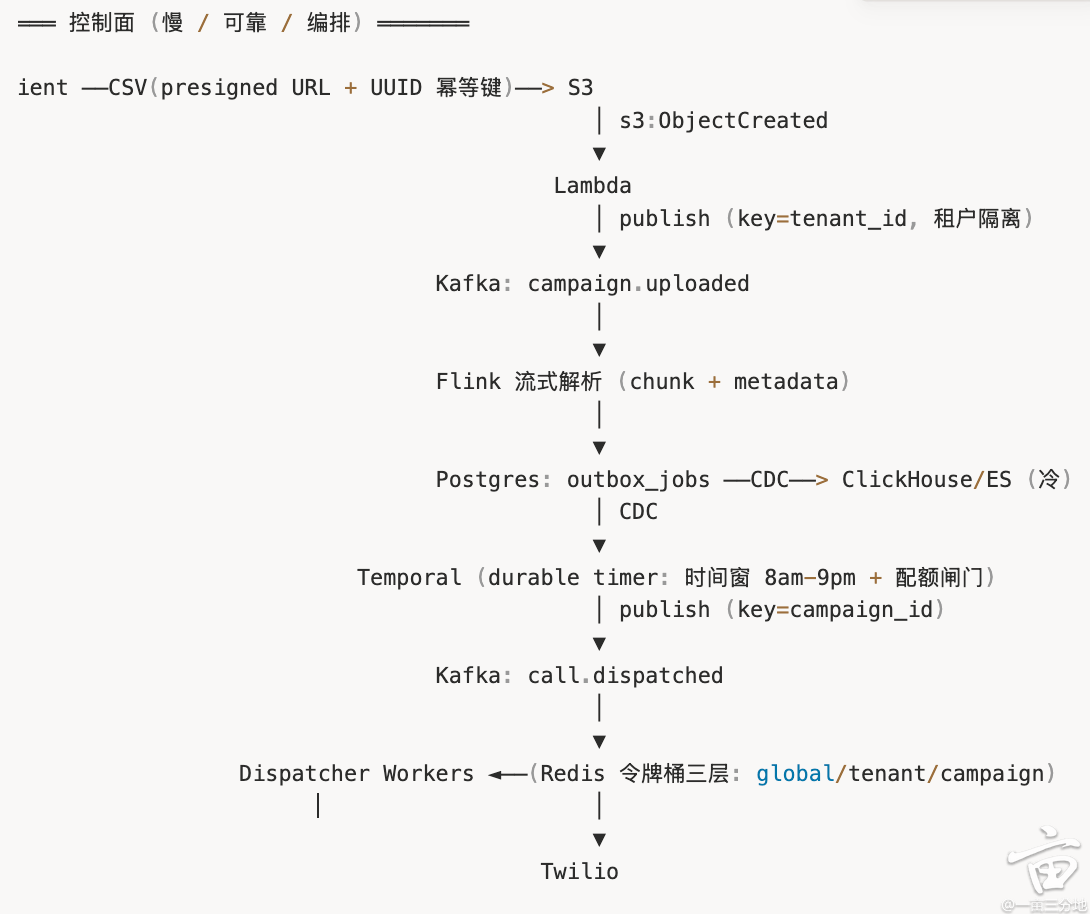
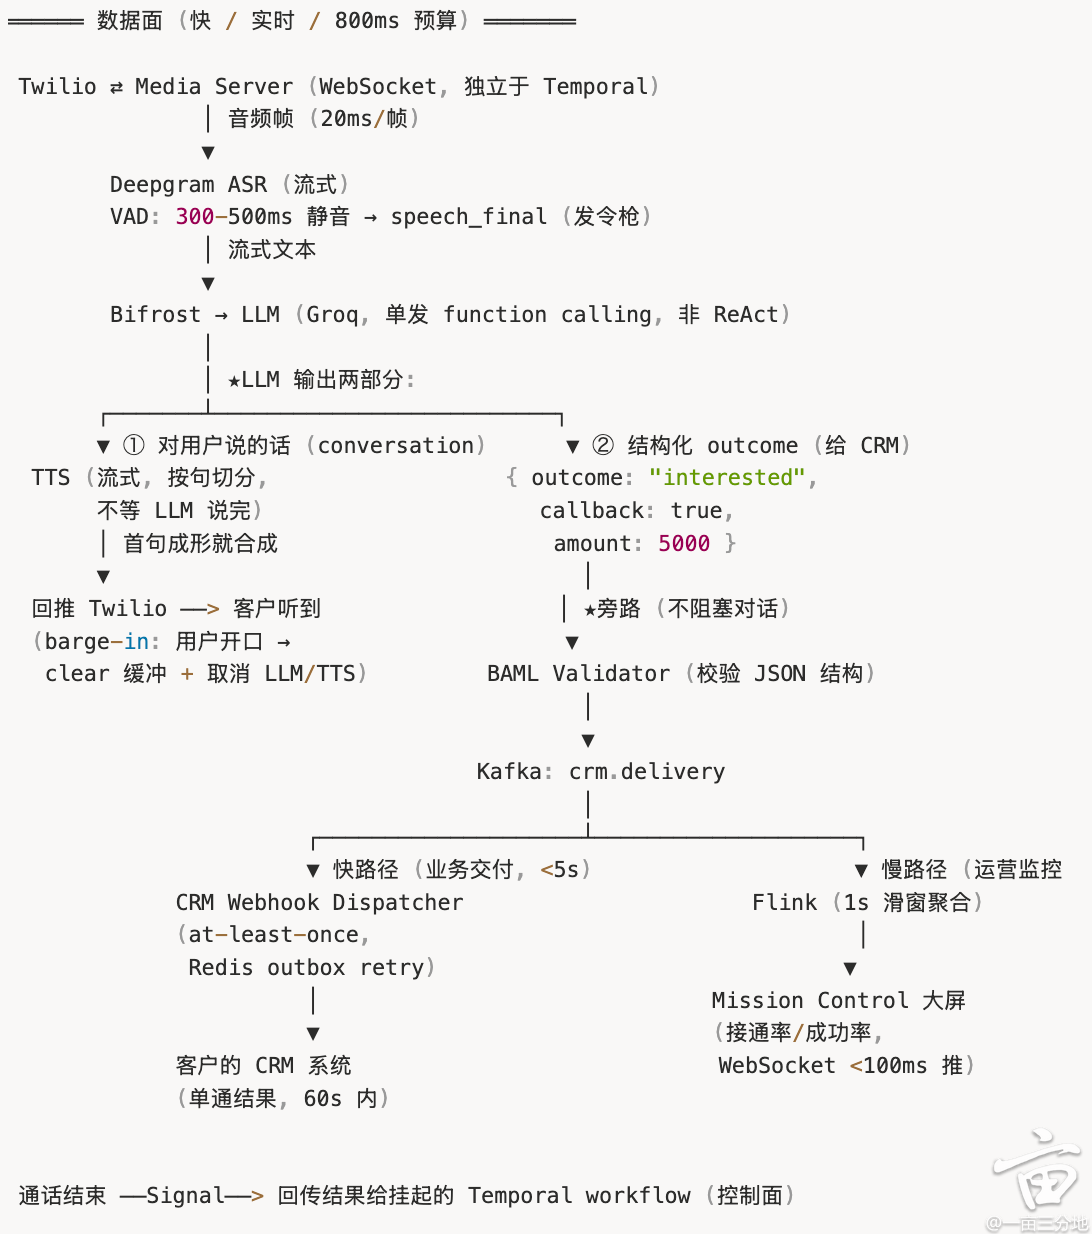
为金融客户设计 outbound voice AI 的 call orchestration平台。接收联系人 CSV campaign,按 campaign 限并发,经 Twilio 拨打,产出 transcript + 结构化 outcome,60 秒内 webhook 回传 CRM。日 100 万通、峰值 1 万并发、at-least-once、单通失败不影响其他。核心矛盾:控制面(何时打——慢、有状态、要可靠编排)与数据面(实时通话——快、无状态、800ms 延迟预算)是两套完全不同的系统,必须分离,中间用 Kafka 解耦。
控制面:编排、限流、隔离
- 分工铁律:Temporal 决定"什么时候能打"(慢、有状态、可靠),Dispatcher Workers 负责"高吞吐把电话打出去"(快、无状态、可水平扩展)。
- Temporal 的杀手锏是 durable timer:客户在芝加哥凌晨 2 点 → workflow sleep until 8am,进程重启也不丢;"没接通等 4 小时、占线等15 分钟、3 次失败放弃"这种带状态延时重试,用 Kafka consumer 手写非常痛苦。
- 必须 per-call workflow(workflow_id = call-{job_id} 天然幂等)。不能让 Campaign workflow spawn 10 万 child——单 workflow 事件历史上限约 5 万 event / 50MB 会被强制终止;改用 Search Attribute 标签 +批量 signal/cancel 关联。
- 令牌桶是三层树,一次拨号要同时通过:global:twilio(账号硬 CPS)→ tenant:{id}(租户份额)→ campaign:{id}(活动配置)。被拒时返回"哪层卡住":campaign 层卡只 pause 对应 partition(几百 ms 后resume),global 层卡则所有 worker 整体退避——这也是 call.dispatched用 campaign_id 做 partition key 的原因。
- 三种"限制"机制不同:速率 CPS = 令牌桶(Redis);并发上限 =信号量 INCR/DECR(Redis + TTL 防泄漏);每日配额 = 计数器(放 Temporal在派发前拦,别浪费下游资源)。
- 多租户硬隔离:Kafka partition key = tenant_id,防大租户(500 万行)饿死小租户(200 行)。
- 存储分层:上传走 presigned URL 直传 S3(大文件不过应用服务器,URL 带 UUID 幂等键防重复上传造成双倍外呼);巨型 transcript_json不进 Postgres(只更一个状态字段,大文本异步写 ClickHouse/ES);Postgres 用 pg_partman Detach PARTITION 清理(比逐行 DELETE 快)。
- 实时音频不跑在 Temporal 里(不适合 20ms 一帧):Media Server 独立处理,通话结束用 Signal 把结果回传给挂起的 workflow。
- 800ms 预算:VAD 检测到 300–500ms 静音发 speech_final("该 AI说话了"的发令枪);流式 TTS 不等 LLM 说完,按句子边界切分,第一句成形就送合成。
- Barge-in 打断是体验生死线:VAD 检测到用户开口 → 给 Twilio 发clear 清空播放缓冲 → 取消进行中的 LLM/TTS 流 → 转入倾听。
- 热路径不能用 ReAct:一轮 round-trip 就 500ms+,且 Thought 会被TTS 念出来。改用单发 function calling + "好的我帮您查一下哈"填充语掩盖延迟;通话中只暴露 2–4 个工具——最好的工具调用是不调用,客户信息在派发时就预取塞进 payload。
- ASR 选型:Deepgram 与 Whisper 不是二选一——热路径只能用流式ASR(Deepgram),Whisper 是整段进整段出的批处理,只能事后对录音做高质量重转写。
10. Prompt 生成视频(Agentic + RAG)
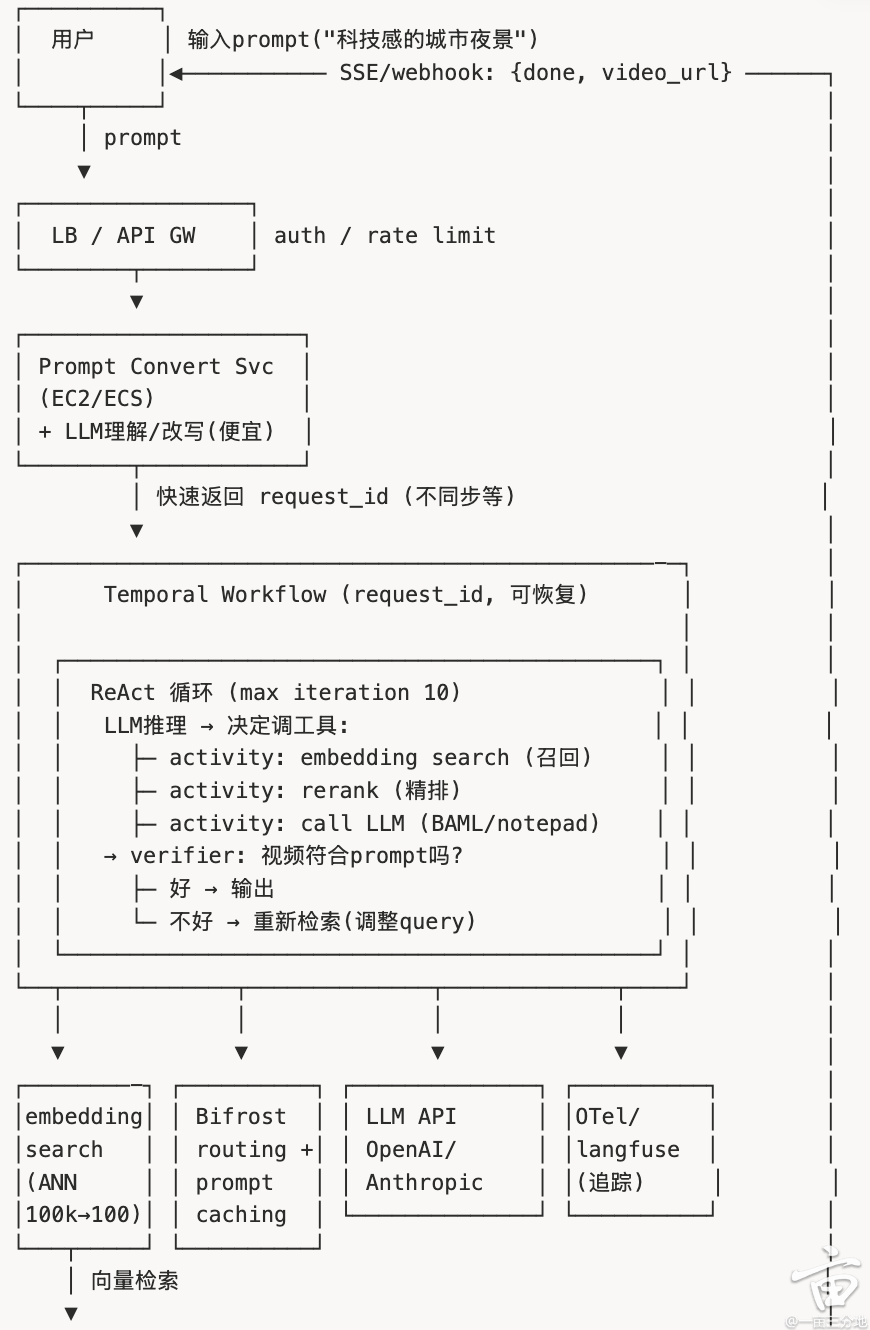
题目:用户输入一句 prompt(如"科技感的城市夜景"),系统从视频库检索并产出一个 10 秒视频返回。要说明检索、agent 编排、视频合成与交付,并回答一次请求至少要调多少次 LLM。核心矛盾: 走检索式路线(从视频库检索+拼接,而非纯文生视频——那极贵极慢);且检索放在 Agentic RAG(ReAct 循环"内"),因为检索不好要能用新 query 重试。
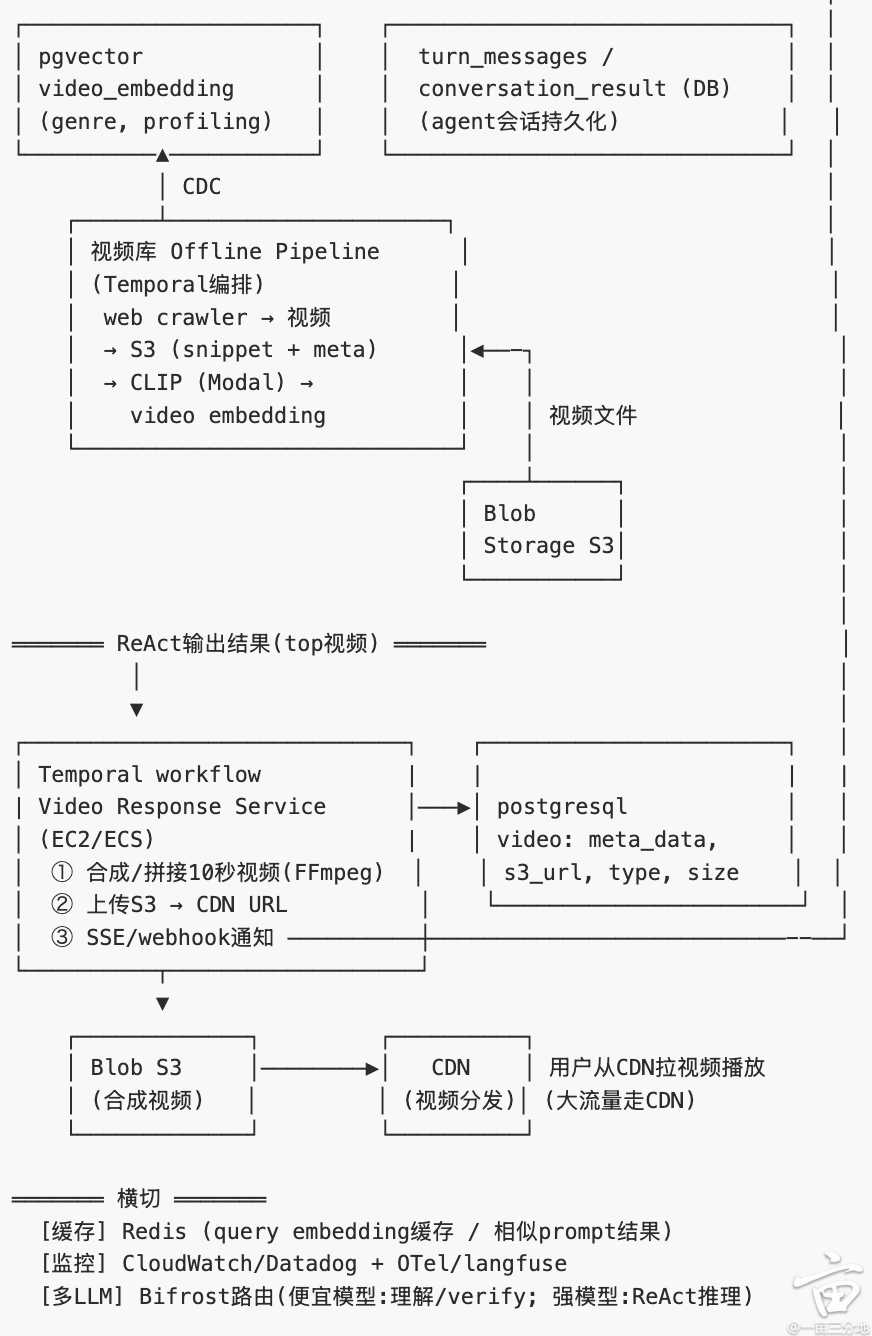
Workflow① Offline (视频库构建):
web crawler → 视频 → S3 → CLIP(Modal) → video embedding → pgvector
用LLM吗?
→ CLIP: 专门的embedding模型(不是生成LLM)
→ crawler/S3: 工程/存储
② Realtime:
a. Prompt Convert(LLM理解 + query embedding):
→ LLM理解/改写: 用LLM (理解意图, 可选/便宜模型)
→ query embedding(CLIP): 专门embedding模型
b. ReAct循环:
→ 召回(ANN 100k→100): 算法(向量检索)
→ rerank(→top10): cross-encoder模型(不是LLM)
→ LLM推理: 用LLM (决策: 够好吗/重试/选哪个)
→ verifier判断: 用LLM (独立验证视频符合prompt)
c. Video Response Service:
→ 合成视频(FFmpeg): 工具(视频处理)
→ S3/CDN: 存储/分发
→ SSE/webhook通知: 工程
③ 视频交付:
→ SSE/CDN
Agent 编排(核心)
- 核心决策:embedding search 必须放在 ReAct 循环"内"(Agentic RAG) ——检索不好要能用新 query 重试(不是固定检索一次)。
- 循环内的 LLM vs 循环外的 Verifier:决策者带着 notepad 全部检索历史,判断天然有偏见;Verifier 用全新上下文只看 prompt + 最终视频,独立视角、无共享盲区——两层判断。
- 必须用 CLIP 类模型,不能用文本 embedding:视频用 CLIP 编码,query也必须用 CLIP,才在同一向量空间(query 与库同编码器 + 同聚合方式)。
- 两阶段:召回用 CLIP(bi-encoder,海量快,ANN 100k→100);精排用cross-encoder(query+候选一起输入算相关分,准但慢,只对 top 少量)。
- SSE/webhook 只推 {status, video_url} 小消息;视频大文件走 CDN让用户自己拉,不经后端。
- 异步:先返回 request_id(不同步等),FFmpeg 合成(裁剪/拼接/转码)用 Temporal 编排,完成再通知。
- 分生成式 LLM call(贵)和 embedding/rerank(模型调用,不算):
- 最好 2–3 次(理解 1 + ReAct 1 + verify 1)
- 典型 5–7 次
- 最坏打满 10 轮约 20+ 次
- 按任务路由省钱:prompt 理解 / verifier 用便宜模型,ReAct 推理用强模型,embedding 用 CLIP,rerank 用 cross-encoder。
小结
感谢你看到这里!我感觉这一章的内容之多, 可以出本小册子了。。。总结一下,
传统的系统设计没什么变化,还是老一套。
这次明显感觉到:async event 的幂等处理、lock / distributed lock、以及 fan-out 被多家公司考到——有的放在 PR debug 里考,有的放在 system design 里考,请多多复习。
AI 的系统设计现在群魔乱舞,面什么的都有。建议还是从最基础的几种准备起:RAG、AI agent (ReAct)、多模态 (chatbot 文本 / 视频、语音客服)
总体来说在AI时代,System Design 的权重似乎加重了,因为有公司连出 3 轮 SD, 完全没coding。
最后一句心得:AI Agent Engineer 首先需要掌握传统的系统设计,这是地基。
下一章讲 Hiring Manager round 和其他体会。
已获得 133 大米


+2
共13条回复

